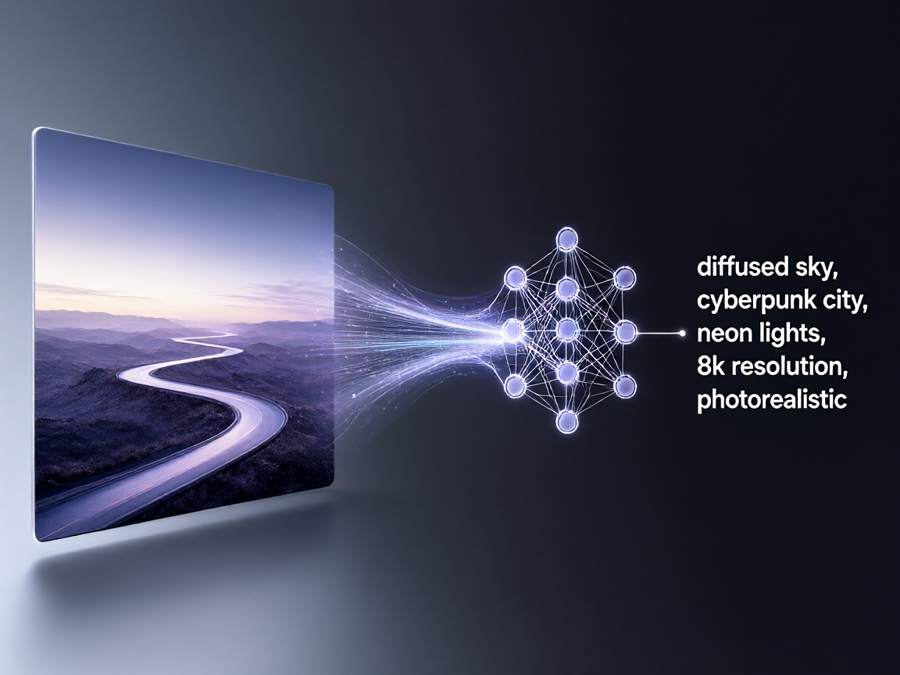
在 AI 绘画(Midjourney、Flux、Stable Diffusion、DALL-E 3 等)盛行的今天,许多创作者常常遇到这样一个痛点:看到一张极其吸睛的图片,却不知道怎么写提示词(Prompt)才能还原出同款质感和画风。 简单的 CLIP 识别或者模型粗暴反推,往往只能给出几个干瘪的单词,丢掉了光影、材质、视角与后期氛围的核心细节。
为了解决这一难题,GitHub 上近期爆火的开源技能项目 image-prompt-reverse(GitHub: LunarXuan/image-prompt-reverse)应运而生。它是一个专门为 AI Agent(如 Codex / Claude Code)设计的高保真图片提示词逆向工程 Skill,能够像专业摄影师与视觉美术指导一样,将一张图片像素级拆解为极其精准的文字 Prompt。
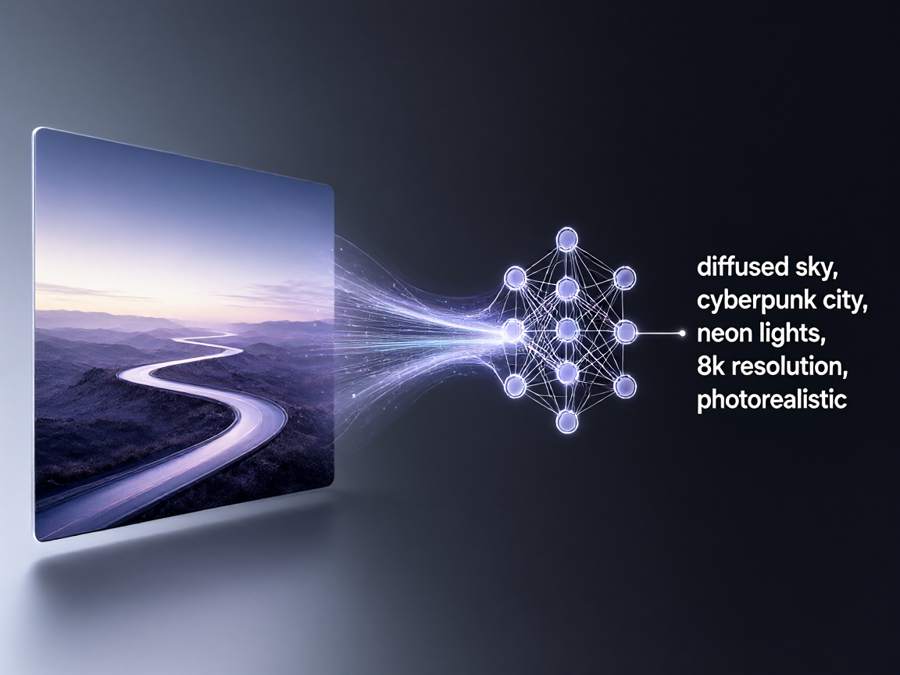
为什么传统的图片反推工具不够用?
很多玩 AI 绘画的朋友都用过基础的 describe 功能或简单的多模态反推,但常见的问题非常明显:
1. 词汇过于泛化:只识别出“一个女人,在街上”,忽视了景深、镜头焦段、色温与光线品质。
2. 风格幻觉:经常混淆插画与 3D 渲染,或者把盲盒潮玩风格误判为传统画作。
3. 缺少负面提示词(Negative Prompt):无法自动提取那些“不该出现”的混淆元素。
而 image-prompt-reverse 的核心逻辑是系统化的专业视觉拆解。
核心亮点:像视觉总监一样“读图”
1. 全维度的 12 项视觉要素拆解
它不是机械地罗列标签,而是按照一套严密的视觉分析框架,对图片进行深层次剖析:
– 媒介与风格:精确区分胶片摄影、二次元插画、3D 黏土潮玩、赛博朋克手绘等。
– 主体与细节:服装材质、表情微动作、IP 角色特征、甚至多主体间的空间布局。
– 镜头语言与构图:俯视/仰视视角、三分法/对称构图、景深虚化程度、特写还是全景。
– 光影与色彩:冷暖色调搭配、柔光/硬光、逆光轮廓、电影级调色质感。
2. 输出 450-700 字高保真 Prompt + 精确 Negative Prompt
传统的反推往往只有三五个单词,而 image-prompt-reverse 默认会输出:
– 450–700 字的中英文自然语言 Prompt:叙事清晰、细节丰富,可直接喂给 Midjourney 或 Flux 生成极度接近原图的视觉成果。
– 10–15 条英文 Negative Prompt:剔除容易混淆的风格与瑕疵,确保生成画面干净。
3. 提炼 3-5 个“视觉锚点”,拒绝凭空捏造
项目最聪明的地方在于它懂得抓主次——优先提炼最影响视觉相似度的 3 到 5 个关键锚点,对于因模糊或遮挡看不清的细节绝不胡编乱造,保证了 Prompt 的极高可重现性。
广泛的场景覆盖
无论是设计还是日常创作,它都能轻松应对:
– 摄影类:人像、商业产品图、纪实摄影、美食、城市建筑。
– 插画类:二次元、治愈系手绘、国风潮插、扁平插画。
– 3D 与潮玩:写实渲染、黏土手办、盲盒 Q 版角色。
– 平面设计:Logo、创意海报、抽象图形、排版设计。
快速安装与使用
项目专为 AI Agent 设计,安装只需一行命令即可克隆到本地 Skill 目录:
# 克隆到 Codex / Agent 的 skills 目录下
git clone https://github.com/LunarXuan/image-prompt-reverse.git "%USERPROFILE%\.codex\skills\image-prompt-reverse"
安装完成后,只需对 AI Agent 发送图片并调用 $image-prompt-reverse,即可秒级获取专业级的提示词配方。
总结
image-prompt-reverse 不仅是一个提示词反推工具,更是一套系统化的“视觉解剖手册”。它让创作从凭感觉摸索,变成了有据可依的精准复刻。
如果你也想彻底攻克 AI 绘画调教难的问题,不妨去 GitHub 了解并使用这个项目:GitHub – LunarXuan/image-prompt-reverse。