语音合成圈又来了个”掀桌子”的:VoxCPM2(OpenBMB 出品),干脆把主流 TTS 的”离散 token 化”环节整个砍掉了——不量化、不查码本,用扩散自回归架构直接在连续音频隐空间里生成语音。仓库 38.7k Star、4.4k Fork,Apache-2.0 协议,权重代码全开,商用免费。
它能干什么,一句话版本:
- 30 种语言直接合成,不用打语言标签,还支持 9 种中文方言(四川话、粤语、吴语、东北话、河南话、陕西话、山东话、天津话、闽南话)
- 声音设计:不给任何参考音频,一句自然语言描述(性别、年龄、音色、情绪、语速)就能捏出一个全新声音
- 可控克隆:短参考音频克隆音色,还能加指令调情绪、调语速、调风格
- 终极克隆:参考音频 + 对应文本一起给,连节奏、情绪、说话习惯都复刻,还能无缝续写
- 48kHz 录音棚音质输出,内置超分辨率,不用外挂上采样器
- 4090 上 RTF 低至 ~0.3,接上 Nano-vLLM 或 vLLM-Omni 后到 ~0.13,实时流式无压力
无 tokenizer 是什么意思?
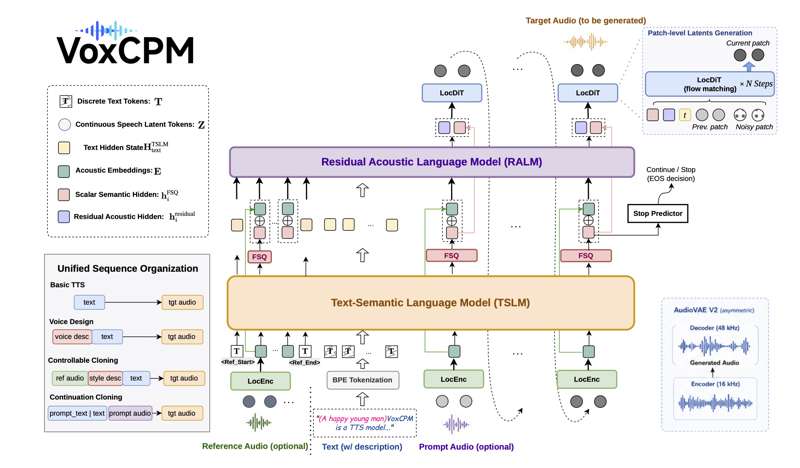
传统 TTS 管线里,文本和音频都要先离散化成 token,再用语言模型去”预测下一个 token”。量化这一步本身就是有损压缩,细节、情感、语气的损失大半从这来。
VoxCPM2 的做法:整个模型跑在 AudioVAE V2 的连续隐空间里。文本侧由 MiniCPM-4 骨干驱动(2B 参数、200 万小时多语言语音数据训练),音频侧用扩散方式逐步”雕”出连续表示——没有码本,没有量化误差,表现力自然上来了。技术报告在 arXiv:2606.06928。
在公开评测上,Seed-TTS-eval 英文 WER 1.84 / 相似度 75.3,中文 CER 0.97 / 相似度 79.5,多语言测试里英语相似度 85.4、粤语 83.5,多语种 WER 与 FishAudio S2、Minimax 等闭源商用服务打得有来有回。
5 分钟上手
安装就一行(Python ≥3.10,PyTorch ≥2.5):
pip install voxcpm
文字直接合成:
from voxcpm import VoxCPM
import soundfile as sf

model = VoxCPM.from_pretrained("openbmb/VoxCPM2", load_denoiser=False)

wav = model.generate(
    text="VoxCPM2 is the current recommended release for realistic speech.",
    cfg_value=2.0,
    inference_timesteps=10,
    seed=42,
)
sf.write("demo.wav", wav, model.tts_model.sample_rate)
声音设计——重点来了,把描述放进 text 开头的括号里,一个参考音频都不用传:
wav = model.generate(
    text="(A young woman, gentle and sweet voice)Hello, welcome to VoxCPM2!",
    cfg_value=2.0, inference_timesteps=10, seed=42,
)
可控克隆——给一段参考音频克隆音色,再叠控制指令:
wav = model.generate(
    text="(slightly faster, cheerful tone)This is a cloned voice with style control.",
    reference_wav_path="path/to/voice.wav",
)
流式输出也有现成 API,model.generate_streaming(text=...) 逐 chunk 出音频。
CLI 同样齐全:voxcpm design(造声)、voxcpm clone(克隆)、voxcpm batch(批量),还支持 --timestamps 导出词级/字级时间戳(stable-ts),做字幕对齐够用了。
部署:从 MacBook 到生产集群都有路
| 场景 | 方案 | 性能 |
|---|---|---|
| 本地体验 | python app.py WebUI,Apple Silicon 自动走 MPS |
— |
| 生产高吞吐 | Nano-vLLM-VoxCPM | RTF ~0.13(4090) |
| 生产多租户 | vLLM-Omni,OpenAI 兼容 /v1/audio/speech |
PagedAttention + 连续批处理 |
| 端侧无 Python | llama.cpp-omni,GGUF 量化 | RTF ~1.76(M4 Pro / Metal) |
端侧方案值得单说:下载 GGUF 权重(BaseLM + Acoustic 两个文件,Q8_0 体积减半质量几乎无损),CMake 编译出 voxcpm2-cli,Mac/Linux/Windows 的 CPU、Metal、CUDA、Vulkan 都能跑。一个 2B 的 48kHz TTS 模型能在笔记本上离线跑通,放在一年前是不敢想的。
vLLM-Omni 的接入方式对后端同学最友好,装好后一行命令起服务,任何 OpenAI SDK 改个 base_url 就能调:
vllm serve openbmb/VoxCPM2 --omni --port 8000

curl http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"model":"openbmb/VoxCPM2","input":"Hello from VoxCPM2!","voice":"default"}' \
  --output out.wav
版本怎么选
- VoxCPM2(2B,最新):30 语言、声音设计、可控克隆、48kHz——要能力就选它,显存 ~8GB
- VoxCPM1.5(0.6B):中英双语、续写式克隆,更轻(~6GB 显存),RTF 更低
- VoxCPM-0.5B:最轻量(~5GB),16kHz,适合资源受限场景
三个版本全部支持 SFT / LoRA 微调,lora_ft_webui.py 提供了微调 WebUI。
诚实提示
声音克隆是把双刃剑。项目在 README 里明确列了 Risks and Limitations:克隆他人声音需获授权,生成内容的 misuse 风险由使用者自行承担。做产品接入时,声纹级别的授权核验和内容水印建议一步到位。
另外硬性门槛:当前 Python API 需要 CUDA 环境(Windows 也仅支持 Linux WSL);Mac 用户想在本机玩,走 WebUI 的 MPS 路径或 llama.cpp-omni 端侧方案更省事。
仓库:github.com/OpenBMB/VoxCPM | 在线体验:HuggingFace Space | 音频样例:官方 Demo 页 | 文档:readthedocs