一句话:把通常要服务器集群才能跑的 Qwen3.8-Flash-Next(125B),塞进一张 12GB 显存的游戏显卡里,还给你 OpenAI 兼容接口。
GitHub:Niko1221/Strata | ⭐ 12.5k | Fork 1.1k | MIT 协议
它是什么?解决什么问题?
125B 参数的模型,正常理解是”租卡吧,一张 H100 一小时几十块”。Strata 干的是反常识的事:让它在你家 RTX 5070 / RX 9070 XT 这种消费级显卡上跑起来,聊天、写代码、看图都行,数据不出你家 PC,还顺手给你 localhost:8080 的 OpenAI / Anthropic 兼容 API——Claude Code、Cursor、Codex 全能接。
原理一句话(官方”厨房论”):模型是 24576 个小专家组成的团队,每个词其实只需要其中 10 个。于是常用的专家放台面(显存),全部专家放 pantry(内存),再配一张 SSD 上的检索表,CPU/GPU/内存/硬盘四件套一起上。再加”小模型先猜、大模型批量验”(speculative decoding,同答案快 1.6–1.8 倍)和 8K token 一块读的预填充,速度就起来了。
核心优势:数字说话
1. 速度:5070 上 94 token/s,比你读得快
官方实测(RTX 5070 12GB,短回答场景):
| 量化档 | 写回答 | 读提示(32K 文档) |
|---|---|---|
| Q2_0 | 94 tok/s | 2650 tok/s |
| IQ2_XS | 79 tok/s | 2090 tok/s |
| IQ3_S(最准) | 53 tok/s | 1620 tok/s |
60 tok/s 就超过人类阅读速度。显存更大的卡更快:RTX 3090 24GB 能到 100–140 tok/s 写回答。
2. 安装:双击 bat,剩下交给它
Windows 双击 START-HERE.bat,Linux 跑 ./setup.sh:自动识别 N 卡/A 卡、问你内存选档、拉约 70GB 模型(断点续传)、打开浏览器 127.0.0.1:8080。懒人终极版:把仓库里那句 prompt 扔给你的 AI 编程助手,让 AI 替你装,装完还能通过 MCP 服务器启停 Strata。
3. 选型表:内存多大办多大事
| 内存 | 拿哪个档 |
|---|---|
| 32GB | Coder(代码特化,SWE-bench 达完整版 91%,但中文弱,CJK 需求选 Q2_0/IQ2_XS) |
| 48GB | IQ2_XS(或最快的 Q2_0) |
| 64GB | IQ2_XS 起步,IQ3_S 最准 |
| 96GB+ | IQ3_S,或 Unsloth 4-bit 版 |
4. 接口:本地就是云
- OpenAI 兼容:
http://127.0.0.1:8080/v1(Key 和模型名随便填); - Anthropic 兼容:
/v1/messages,Claude Code 一行环境变量就切过来; - Codex Responses API 也有;浏览器里还有 Chat + 实时 Monitor(GPU/CPU/内存状态)+ 图片输入。
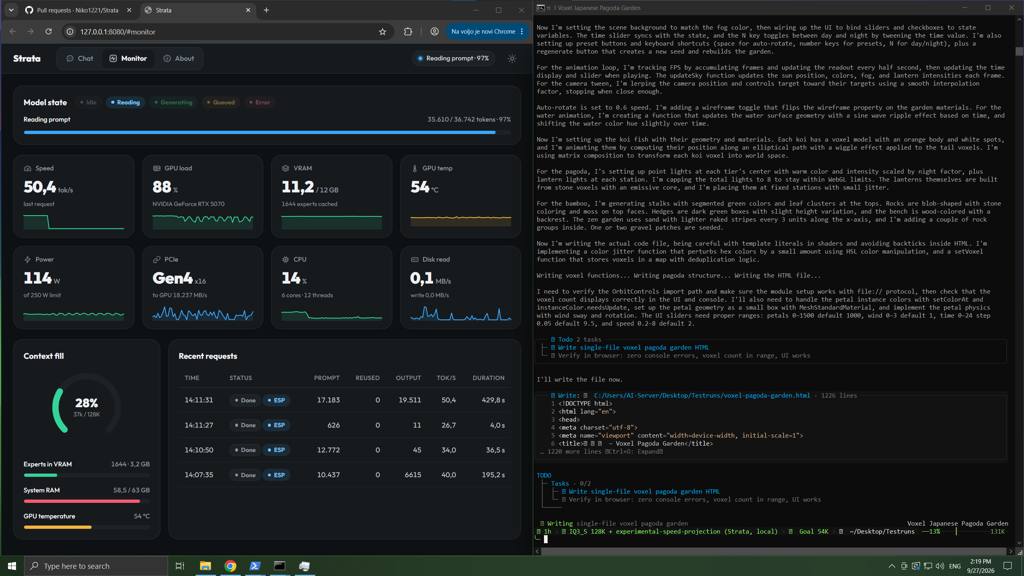
5. 网友实测背书:RTX 5070 一发写体素宝塔
README 置顶就是社区实拍:5070 上 IQ3_S、128K 上下文,一句话 prompt 生成体素宝塔花园,还有 49 秒完整视频。不是跑分截图,是真干活。
网友实测:RTX 5070 上 IQ3_S 一句话写出体素宝塔(仓库官方动图,流量注意)。
门槛和边界(先看再下 70GB)
- 硬件:12GB+ 显存显卡(20/30/40/50 系或指定 A 卡)、32GB+ 内存、约 80GB SSD 空间,Win10/11 或 Linux;
- 首次启动卡 1–3 分钟是正常的(往内存锁 35–55GB),别关窗口;
- 慢 + 爆盘灯狂闪 = 内存不够,关浏览器或换小档;
- Coder 档中文弱、AMD 在 Windows 下还不能看图、混杂多语有短板——玩之前先看
docs/里对应的说明; - 模型本体另有授权(Qwen 系),商用前看一眼。
结语
本地大模型的分水岭早就不是”能不能跑”,而是”跑得像不像云”。Strata 的答案是:把 125B 塞进游戏 PC,再用一套兼容接口抹掉本地和云的区别。12.5k Star,投的是这一票。
仓库:github.com/Niko1221/Strata(MIT)。动手前先对着”内存选型表”看一眼,别下错档。