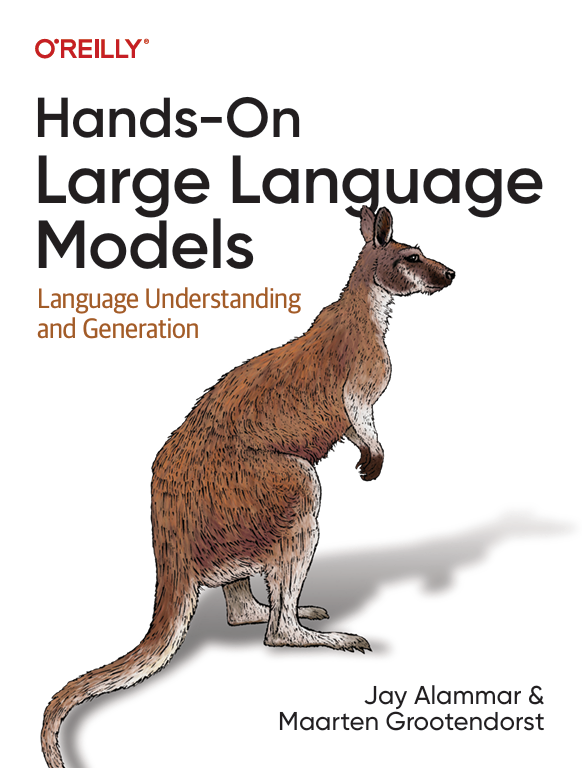
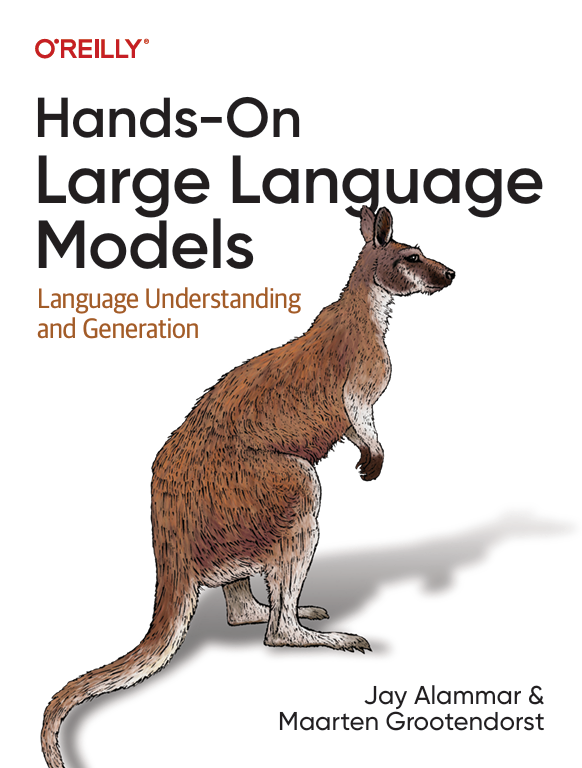
一句话:Transformer 看不懂?这本书用近 300 张自制插图+可运行代码,把 LLM 从 token 一路讲到微调。
GitHub(官方代码仓):handsOnLLM/Hands-On-Large-Language-Models | ⭐ 29.4k | Fork 6.7k | Apache 协议(代码)
作者:Jay Alammar × Maarten Grootendorst | 出版社:O’Reilly | 配套:12 章 Colab Notebook + bonus 追新章节
先说结论:这书强在哪
市面上 LLM 书分两类:一类是”调包指南”(教你调 API 做应用),一类是”论文综述”(公式堆满页)。这本书是第三类:先给你直觉和图,再给代码——每一章都是一套”图解 + 可运行 notebook”的组合拳,读完能动手,动手时心里有画面。
三个数字说明分量:近 300 张全自制插图(作者们自称 “The Illustrated LLM Book”)、12 章 + bonus 追新章节、Andrew Ng、Nils Reimers、StatQuest 的 Josh Starmer 联名推荐。 hypnotic 的不止是插图:它是大模型时代少见的、把”生成”和”表示”两条线都讲透的书(后面细说,这是全书最大的差异化)。
为什么是这两个人写:图解传统
Alammar:图解 Transformer 的那个男人
Jay Alammar 从 2018 年起写的图解系列——The Illustrated Transformer、The Illustrated BERT、The Illustrated GPT-2、The Illustrated Word2vec——是无数人理解注意力机制的第一入口,被斯坦福、MIT 等高校课程引用。他的讲法有个固定套路:
- 先给一个生活直觉(比如把 attention 说成”查字典”:query 去 key 里检索,按匹配度加权取 value);
- 再给一张动态可交互的图(attention 权重热力图,哪个词看哪个词一目了然);
- 最后才给矩阵运算和代码(Q、K、V 矩阵怎么乘,softmax 落在哪)。
这本书就是把这套讲法从几篇博客,系统化沉淀成了 12 章。
Grootendorst:表示线的一手经验
Maarten Grootendorst 是 BERTopic、sentence-transformers 生态的核心贡献者。他带来的恰恰是大多数 LLM 书缺的那一半:模型不生成文本、而是把文本变成向量的应用——分类、聚类、主题建模、语义搜索、RAG、训练自己的嵌入模型。这部分不是纸上谈兵,是他做 BERTopic 时踩坑踩出来的。
12 章三段式:照着 Nils Reimers 的概括读
Cohere 机器学习总监、sentence-transformers 作者 Nils Reimers 在书评里把全书概括为三类应用——生成式、表示式、检索式。顺着这个分法,12 章刚好切成三段,阅读路线一下就清楚了:
| 段 | 章 | 讲什么 |
|---|---|---|
| 理解模型 | 1–3 | 语言模型是什么;token 和嵌入怎么工作;Transformer 内部长什么样 |
| 表示与检索 | 4、5、8、10、11 | 文本分类;聚类与主题建模;语义搜索和 RAG;自己训练嵌入模型;微调 BERT 类表示模型 |
| 生成与微调 | 6、7、9、12 | 提示工程;高级生成(采样、结构化输出等);多模态;微调生成模型 |
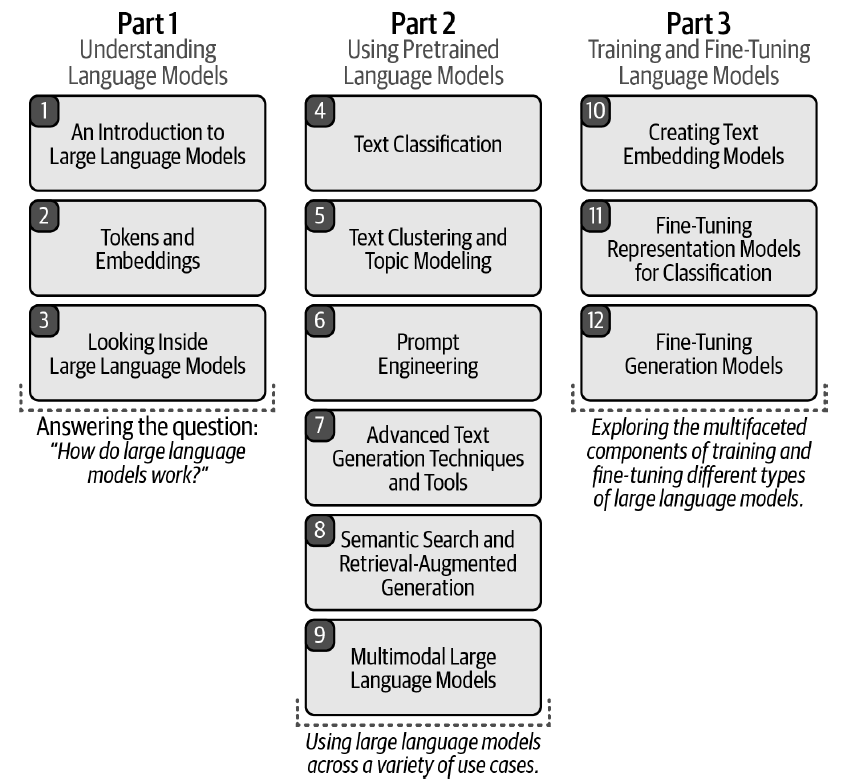
第一段:理解模型(1–3 章)——地基
第 1 章从”语言模型到底在干什么”起手(预测下一个 token 这件小事如何滚成大模型),第 2 章讲 token 切分与嵌入(词是怎么变成向量的),第 3 章 “Looking Inside Transformer LLMs” 是全书的心脏:Illustrated Transformer 的更新版,把 encoder、自注意力、多头、位置编码、前馈网络一层层剖开。这一段读完,”Transformer 黑盒”在你脑子里应该已经是透明管道了。
第二段:表示与检索(4、5、8、10、11 章)——本书的护城河
这是全书区别于其他 LLM 书的部分。大多数书写到生成就收尾了,这里反而用 5 章讲”向量那一半”:
- 第 4 章文本分类、第 5 章聚类与主题建模:嵌入向量最直接的变现,BERTopic 就是第 5 章的亲儿子;
- 第 8 章语义搜索与 RAG:从向量检索一路讲到检索增强生成,企业落地最高频的章节;
- 第 10 章训练自己的嵌入模型、第 11 章微调 BERT 类模型:当开源嵌入模型不够用(垂直领域、私有语料),这两章告诉你怎么自己造轮子、怎么调教表示模型。
一句话:生成负责”说”,表示负责”懂”,检索负责”查”——只懂说不懂查,做出来的东西就是幻觉多、落地少。
第三段:生成与微调(6、7、9、12 章)——动手
提示工程(第 6 章)打底,高级生成技术(第 7 章:采样策略、结构化输出、工具调用等)进阶,多模态(第 9 章)开眼界,微调生成模型(第 12 章)收官——从”会用”走到”会调”。
重点分析:第 3 章的图解到底好在哪
(应读者要求,这里把 Alammar 第 3 章/Illustrated Transformer 式的图解讲法拆开说透。)
第一层:比喻先行,公式断后。 Self-attention 被翻译成”每个词都在向全句提问”:query 是”我想找什么”,key 是”我有什么”,value 是”找到给你什么”。The animal didn't cross the street because it was too tired 里 it 到底指谁?一张 attention 热力图直接给你看答案——it 的注意力大头落在 animal 上。一张图,胜过三页公式。
第二层:把矩阵画成”流水线”。 Q、K、V 不是抽象符号,图解里它们是三条并排的传送带:先算相似度(点积)、再归一化(softmax)、最后加权求和。每一步的输入输出形状都画出来,维度对不上这种初学者噩梦基本不会发生。
第三层:多头 = 多个视角并行。 8 个头不是”8 倍计算”,而是 8 个侦察兵各盯一种关系(主谓、指代、时态……),最后拼起来。这种”先给分工直觉,再给拼接公式”的顺序,是 Alammar 图解和学院派教材最大的不同。
第四层:位置编码单独成戏。 自注意力本身不认顺序,”我爱你”和”你爱我”看起来一样——于是位置信息必须”加”进去。正弦位置编码那张波形叠加图,是全系列被引用最多的一张之一。
总结一句话:第 3 章的图解哲学是——任何一个数学操作,先问”它在模拟人类的哪种阅读行为”,画出来,再写公式。这也是为什么这套图能进斯坦福、MIT 的课堂:它降低的不是知识本身,而是知识的”首次理解成本”。
怎么用这本书 + 这个仓库
仓库是书的官方代码仓,每章一个可运行的 Notebook,官方建议直接用 Colab(免费 T4 GPU) 跑:
- 零基础:1→2→3→6 章,吃透 Transformer 和提示词,再按需跳;
- 做 RAG/搜索:2→8→10 章,表示线三连,读完能搭能调;
- 做微调:3→11/12 章,表示和生成各一条微调路线;
- 追新:仓库
bonus/目录持续更新(agents、DeepSeek、MoE、推理模型、量化……),书出版之后的新东西在这里补。
适合谁、一句话劝退谁
| 适合 | 说明 |
|---|---|
| 想”真懂”而不是”会调包”的工程师 | 图解把黑盒变透明,代码保证能落地 |
| 做 RAG / 搜索 / 分类的人 | 表示线 5 章是别处凑不齐的 |
| 教师、学生、技术写作者 | 图可以直接拿去讲课(注意 O’Reilly 版权,商用引用看授权) |
| 劝退 | 说明 |
|---|---|
| 只想学调 API 做个 demo | 前 3 章对你偏深,直接看第 6 章+官方文档更快 |
| 零 Python 基础 | 先补 Python,notebook 跑起来才有意义 |
结语
大模型时代不缺”三天速成”的书,缺的是能把直觉种进脑子里的书。Alammar 画了 8 年图,Grootendorst 做了最硬核的嵌入工具,这本书是两人的交集:一半是画,一半是码。
仓库:github.com/handsOnLLM/Hands-On-Large-Language-Models(代码 Apache 协议;书本身走 O’Reilly 渠道,另有 Amazon/Kindle)。Star 之前建议先跑通第 3 章的 notebook——如果那张 attention 热力图让你”啊哈”了一声,这书就值了。