把一条外片变成”母语电影”需要几步?pyVideoTrans 给出的答案是一步:扔进视频,等它跑完——语音识别、字幕翻译、多角色配音、音画同步全部自动完成。这个 19.3k Star、2.4k Fork 的开源项目(作者jianchang512,GPL-3.0,最新版 v4.15 于 10 月 4 日发布)做了三年多,已经是视频翻译这个赛道里最成熟的自托管方案之一。
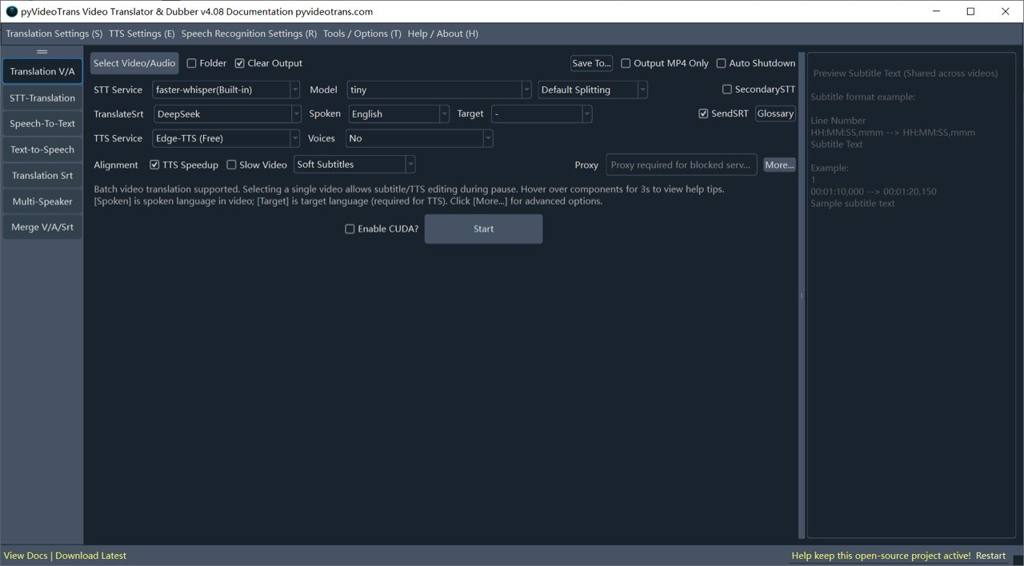
一键流水线:ASR → 翻译 → TTS → 合成
核心流程就是四步管线,GUI 里点一下,CLI 里一条命令:
- 语音识别(ASR):Faster-Whisper 本地跑(推荐,快且准),也接 OpenAI Whisper、阿里 Qwen3-ASR、字节火山、Azure、Google——中文场景国内 API 效果尤其好。还支持说话人分离:能把不同角色的台词拆开。
- 字幕翻译:接 LLM——DeepSeek、ChatGPT、Claude、Gemini、MiniMax、阿里百炼,或者 Ollama 完全本地离线翻译;不想用大模型也有 Google/Microsoft 传统机翻兜底。带上下文理解,比逐句机翻自然。
- 语音合成(TTS):Edge-TTS 微软免费接口起步(零成本就能用),要质量有 OpenAI/Azure/302.AI,要开源本地有 ChatTTS、ChatterBox;多角色配音能给不同说话人分配不同声线。
- 音画合成:自动对齐时间轴,输出成品视频。
声音克隆也内置了:集成 F5-TTS、CosyVoice、GPT-SoVITS、OmniVoice 等模型,零样本克隆——想让”译制腔”变成原主播说外语,这条路是通的。
三个入口:GUI、CLI、WebUI,外加免安装 exe
- Windows 用户:Releases 下载预打包版,解压双击
sp.exe就能用,不碰 Python 环境(注意解压路径别带中文和空格)。 - 开发者:推荐
uv三连——git clone→uv sync→uv run sp.py。 - 团队部署:
uv sync --extra webui起浏览器界面(远程/内网),或docker run -p 7860:7860容器化——服务器批量转译直接挂 CLI。
CLI 四种任务直接批处理:
# 视频翻译 / 语音转字幕 / 字幕翻译 / 文字配音
uv run cli.py --task vtv --name "./video.mp4" --source_language_code zh-cn --target_language_code en --voice_role "en-US-GuyNeural"
uv run cli.py --task stt  --name "./audio.wav" --model_name large-v3
uv run cli.py --task sts  --name "./subs.srt" --target_language_code en
uv run cli.py --task tts  --name "./subs.srt" --voice_role "zh-CN-YunyangNeural"
有 N 卡的还能上 CUDA 加速(官方给出 CUDA 12.8 + cuDNN 9.11 配置),识别速度翻倍。
细节上见真功夫的几点
- 每一步都能人工介入:识别、翻译、配音各阶段都可暂停校对——纯自动管线最怕一处错到底,这个设计把纠错点放在了流程里。
- 辅助工具集齐全:人声分离、视频/字幕合并、音画对齐、文稿匹配,处理”字幕和画面对不上”这种脏活不用再找别的工具。
- 渠道可扩展:文档里有”新增翻译渠道”开发指南,想接自家网关按模板加就行。
- 社区答疑:官方问答区提交报错日志会有 AI 自动分析,比对着日志自己猜快得多。
上手与门槛
git clone https://github.com/jianchang512/pyvideotrans.git
cd pyvideotrans && uv sync
uv run sp.py        # GUI
前置条件就两样:Python 3.10(用 uv 管理)+ FFmpeg(装进 PATH)。翻译和配音的效果取决于你接的渠道——全用 Edge-TTS + 本地 Whisper 是零 API 成本方案;接 DeepSeek/火山这类付费渠道质量更好。
项目定位是开源免费非商业使用,README 也写明了免责声明:调用第三方 API 或处理有版权视频的法律后果自负——拿来做自己的内容出海、课程本地化没问题,商用素材注意版权。
仓库:github.com/jianchang512/pyvideotrans | 官方文档:pyvideotrans.com | 问答社区:bbs.pyvideotrans.com