一句话:自动摸清你的 CPU、内存、显卡,再告诉你几百款模型里哪些能流畅跑、该下哪个量化档。
GitHub:AlexsJones/llmfit | ⭐ 约 3.8 万 | Fork 2.4k | MIT 协议
痛点:别再瞎折腾本地大模型了
很多人兴冲冲下载几十个 G 的权重,拉起 Ollama 或者 llama.cpp,结果显存直接爆掉,或者跑出每秒零点几 token 的龟速——带宽时间全浪费,还要在论坛发帖问”我这配置能不能跑 XX”。
LLMFIT 就是下载模型前的”第 0 步”:先摸清你的硬件家底,再告诉你能流畅跑什么。Rust 写的,macOS、Linux、Windows 全支持,开源免费。
它怎么给你打分:四个维度 + 四档结论
它会自动检测 CPU、内存、GPU/显存(含苹果统一内存),然后从四个维度给每个模型打可行性分:
- 显存匹配度(Memory Fit):模型塞不塞得下,含 Context Window 拉长后的真实开销;
- 推理速度预估:基于你当前后端的真实 tok/s,不是理论值;
- 模型质量与参数规模:大不一定好,够用最好;
- 上下文维度:长上下文需求单独算账。
结论直接给四档标签,一眼看懂:Perfect(完美跑)、Good(跑得顺)、Marginal(勉强跑)、Too Tight(跑不动)。
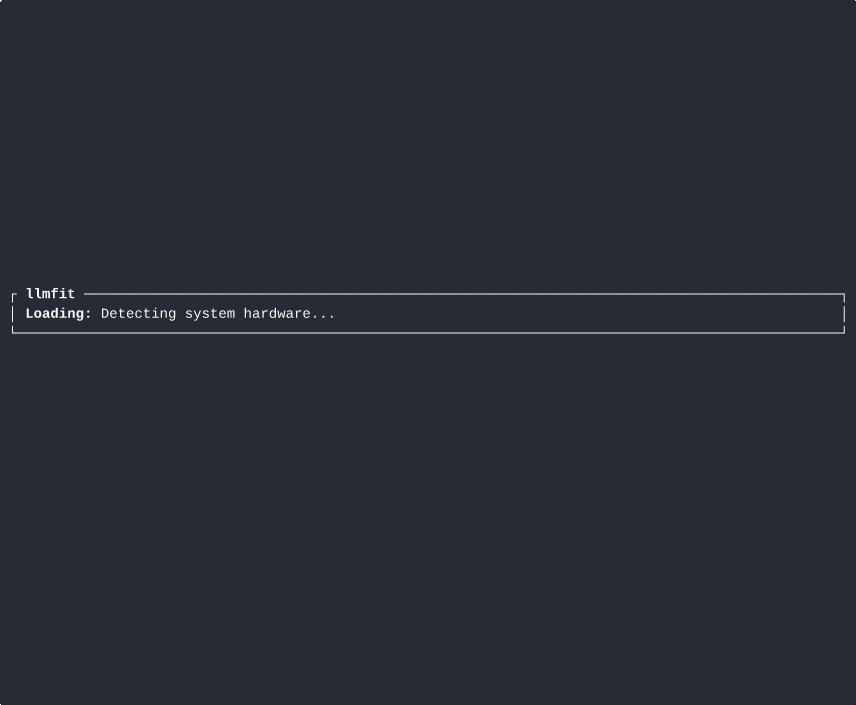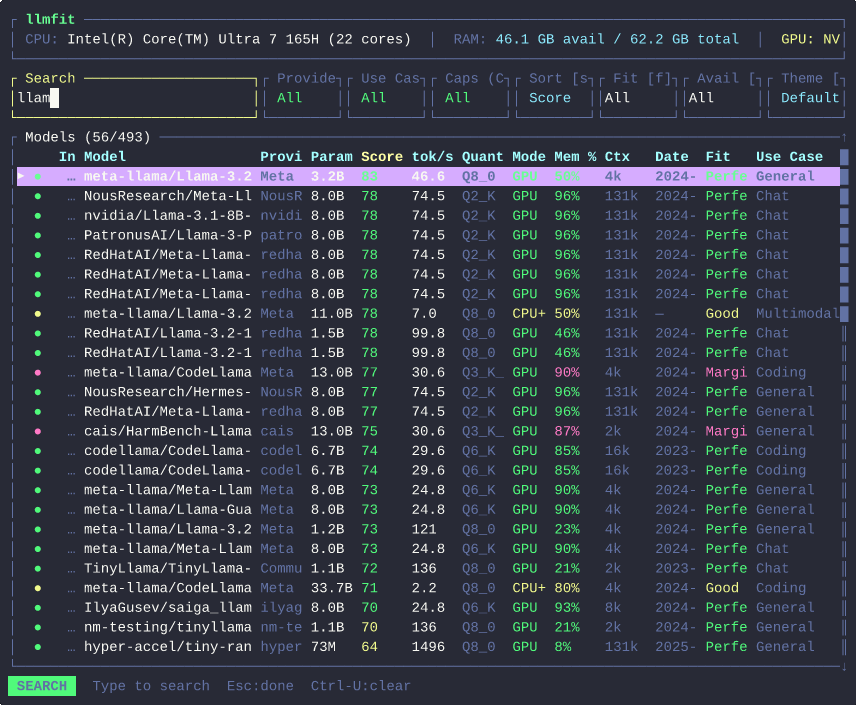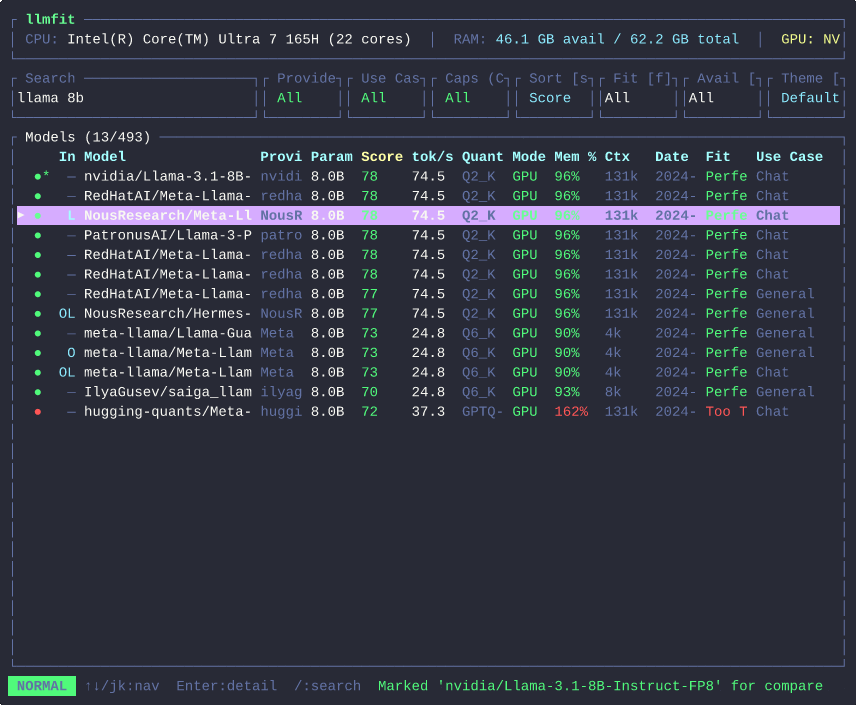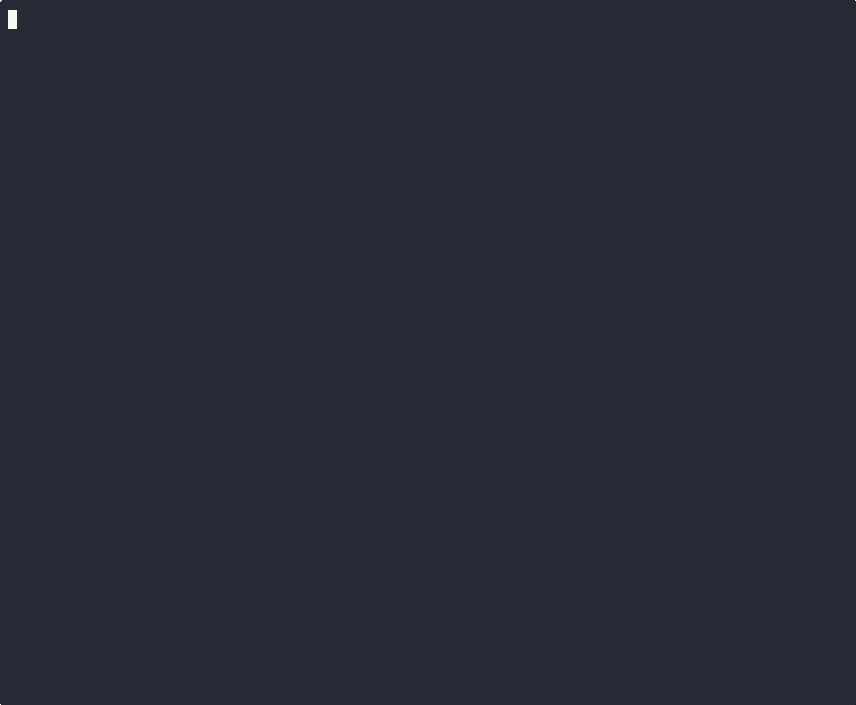
官方演示:TUI 里搜模型、模拟不同硬件、规划部署(仓库官方动图,流量注意)。
最省心的功能:量化档位不用纠结了
以前下 GGUF,总在 Q4_K_M、Q5_K_S 之间盲猜纠结。LLMFIT 按可用显存自动降级匹配,直接挑最均衡的那档。模型库覆盖 DeepSeek、Qwen、Llama、Mistral 等数百款,原生兼容 Ollama、llama.cpp、MLX、LM Studio、Docker Model Runner。
三种用法:终端、网页、API
- TUI:敲
llmfit进交互界面,看 detected 硬件 + 全模型排名,/搜模型,还能模拟”换张卡会怎样”; - 命令行:
llmfit recommend出推荐,--json直接喂脚本;llmfit bench在你机器上测真实 tok/s,llmfit doctor出硬件报告; - Web + API:
llmfit serve起 8787 端口,面板 +/api/v1/models都有,塞进自动化部署流程正好。
另外有个狠活:benchmark & share——你在自己机器上测的真实数据可以 PR 回社区,下个版本所有同配置的人直接看到实测数,不用再估。
安装(一行)
# macOS / Linux
brew install AlexsJones/llmfit/llmfit
# 或
curl -fsSL https://llmfit.axjns.dev/install.sh | sh
# Windows
scoop install llmfit
# Python 党
uv tool install -U llmfit
结语
16G 轻薄本还是多卡工作站,下模型前先跑它看一眼。把”我这配置能不能跑”从论坛提问变成一条命令,这就是 LLMFIT 的价值。
仓库:github.com/AlexsJones/llmfit(MIT)。跑完 llmfit recommend,截图发群里比什么跑分都有说服力。